算法的理论计算复杂度与实际运行时长显然是存在 gap 的——在现代的计算硬件上,我们需要充分考虑到数据的搬运与计算的并行性。例如,在 GPU 上 FLOPs 并不能充分决定实际运行时间。数据在不同存储层次之间的移动、计算任务的并行划分、线程间同步,以及异构计算单元的调度,都可能成为主要性能瓶颈。具体而言,我们从点积注意力的定义出发:
我们将注意力的计算分为三个步骤:
- 计算 Attention Scores:
- 计算 Softmax:
- 计算 Attention Output:
对于 与 的中间状态,我们考虑 32768 的序列长度,使用 FP16 的精度,则每个矩阵需要
而对于结果 ,FP16 的输出矩阵仅需要 4 MiB。换言之,为了得到一个比较小的输出矩阵,我们需要在中间生成两个巨大的矩阵,这会造成 GPU 巨大的读写开销,即 Memory-bound。
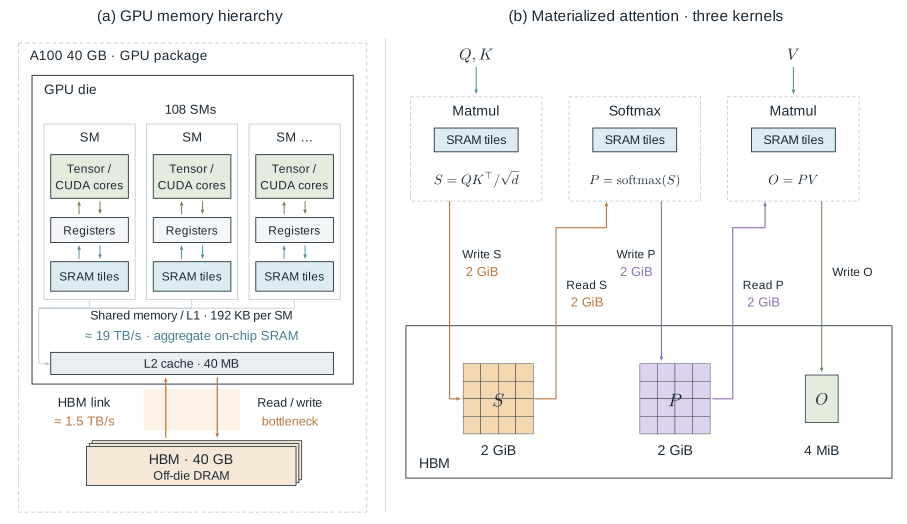
在这一过程中, 与 的中间状态矩阵经历了写入与读出的过程,而 与 的大量显存占用进一步加剧了读写开销——这启发我们保持标准密集 Attention 的数学结构不变,从 GPU 硬件架构出发,重新设计计算过程的数据流与执行方式,充分利用现代 GPU 的存储层次、并行计算资源和异步执行能力。
一个好的算法需要关注以下主题:
- Memory Efficiency:降低数据搬运量,尤其是 HBM 与片上存储之间的 IO。
- Compute Efficiency:提高 Tensor Core 利用率,减少低效的非矩阵乘法运算。
- Parallelism & Scheduling:优化线程、Warp、Thread Block 的工作划分。
- Execution Overlap:通过异步执行和流水线,重叠计算与数据搬运。
FlashAttention 正是围绕以上要点出发。
FlashAttention 1: Data Movement
我们已经发现,临时使用的 与 产生了大量的显存读写开销,然而实际上我们并没有必要保存这些中间结果,那么是否能让它们只在高速 SRAM 中短暂存在,用完以后直接丢弃?
1.1 前向传播
1.1.1 Tiling
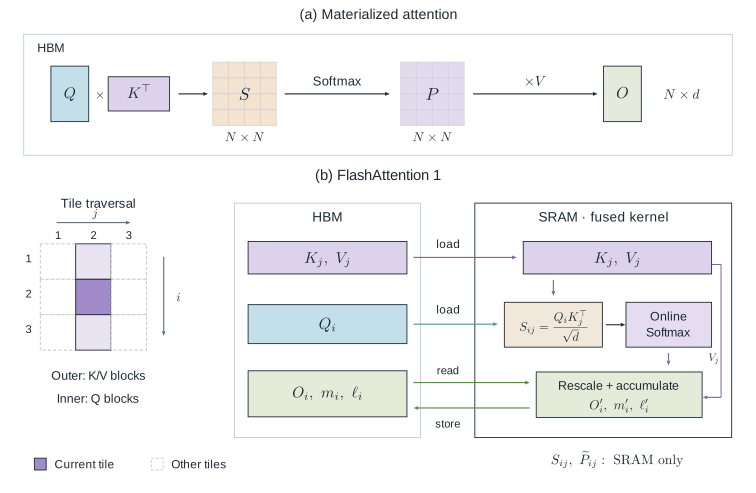
我们遇到的第一个问题在于 与 的中间状态过大,我们无法直接将中间状态载入 SRAM 之中。不过对于 而言,显然我们可以考虑采用分块矩阵的形式进行计算。假设
那么
我们每次计算一个小的分块 ,通过规定 与 的维度,我们显然可以方便调整中间状态的存储占用,以达到优化的目的。
1.1.2 Online Softmax
然而,再计算 Softmax 时,对于每一个 Query,我们需要对不同 K Block 的注意力权重做全局归一化:
这需要我们对分块的结果进行归约,为了避免再产生过大的 矩阵,我们将 Softmax 与最后的点积操作结合,得到最终 Attention 的输出:
我们只需要分别计算 与 ,再利用 ,便可以得到结果。
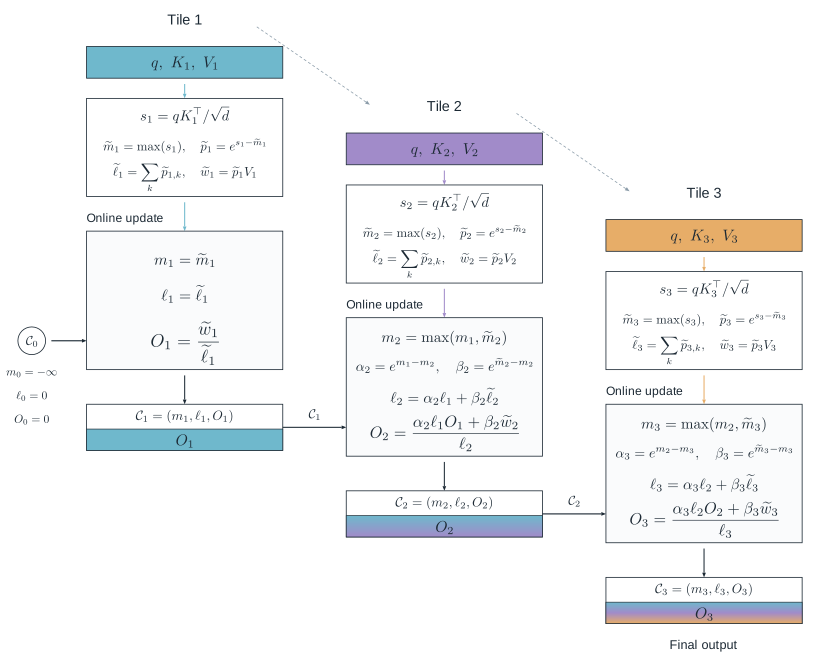
具体而言,为同时避免 Softmax 计算过程中产生的数值溢出的问题,我们对每一行维护三个核心统计量:
在块与块之间,我们采用递推的方式进行更新,以将旧结果与新结果合并。记当前已处理块的统计量为 , , ,现在新加入的块的统计量为 , , 。首先,我们更新最大值:
由于最大值发生了变化,新旧的块指数项必须重新缩放,即分别乘上:
于是,
在实际的执行过程中,由于 可以通过 与 计算得到,整个递归可以写为
其中
1.1.3 Kernel Fusion
最终,为了避免中间结果在多个独立的 CUDA Kernel 之间传递,我们在同一个前向 CUDA Kernel 内完成上述过程
避免了小块计算结果就不必写回 HBM 再被下一个 Kernel 读取。
1.1.4 整体流程
for j in range(num_kv_blocks):
    Kj, Vj = load_to_sram(K[j], V[j])

    for i in range(num_q_blocks):
        Qi = load_to_sram(Q[i])
        Oi, mi, li = load_state(O[i], m[i], l[i])

        # 1. Compute local attention scores
        Sij = Qi @ Kj.T * scale

        # 2. Compute local softmax statistics
        # 3. Merge with previous global statistics
        # 4. Update partial output
        Oi, mi, li = online_attention_update(
            Sij, Vj, Oi, mi, li
        )

        write_state(O[i], m[i], l[i], Oi, mi, li)
1.2 反向传播
1.2.1 普通 Attention 的反向传播过程
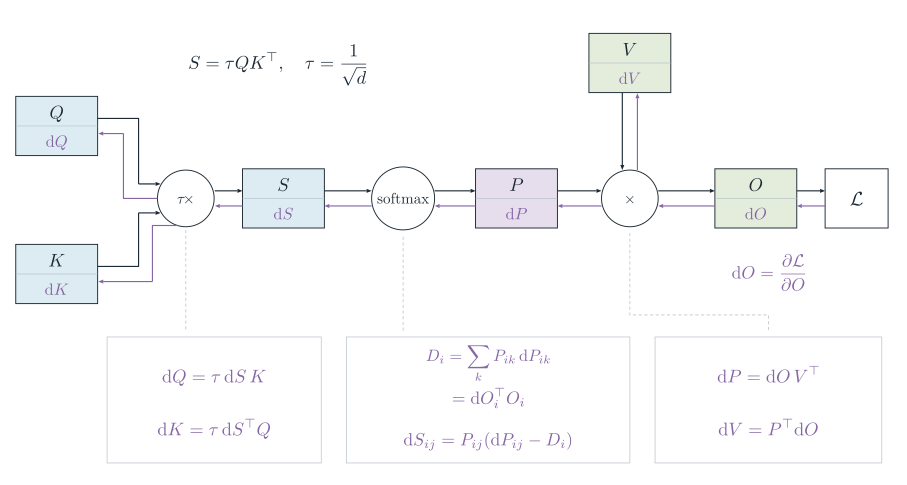
我们主要更新 , , 的权重矩阵。根据计算图,我们首先可以得到
接着由 ,我们计算 和
我们考虑 中的一行 ,根据 Softmax 的偏导数 ,其中 为 Kronecker Delta,得
那么对于第 (i) 个 Query,对应
其中定义
在这里,我们通过变换将计算涉及 Query 对全部 Key 的 Attention 权重转化为两个 维向量的内积,一方面,计算量和所需数据规模都显著减小;另一方面,我们已经在前向传播中保存了 ,而反向传播又天然能够得到 ,避免了加载完整的 或 来进行计算。
最后,我们再根据 ,其中 ,得
1.2.2 Recomputation
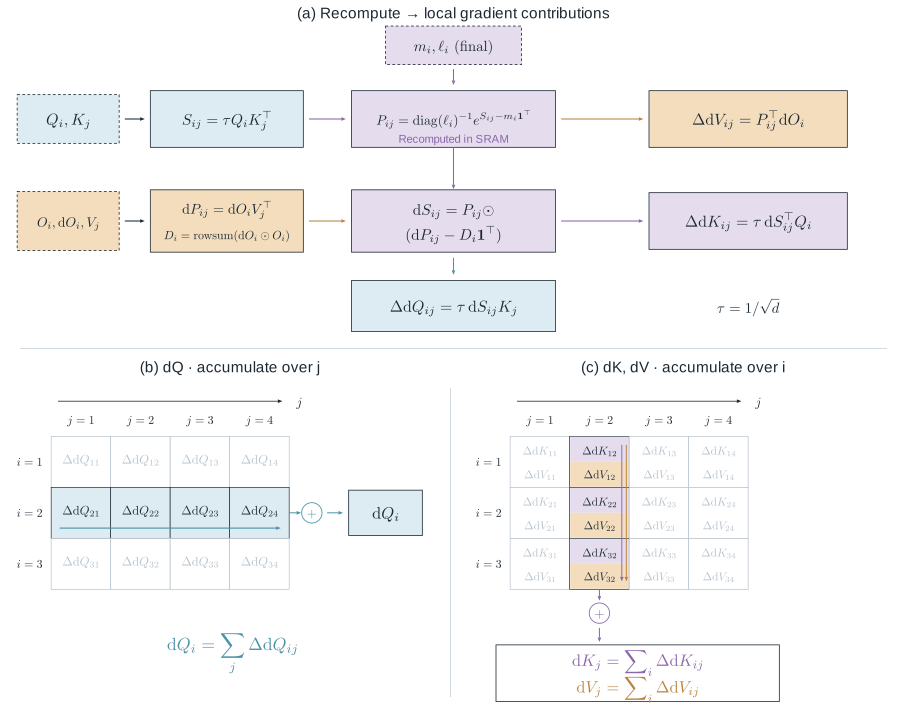
我们可以发现,我们的最终输出 都是相对较小的矩阵,而计算过程中涉及的 , , 都是 的大矩阵,如果直接采用这些大矩阵的话依然会导致访存开销过大的问题,这也就启发我们利用与前向传播类似的分块思想。我们可以将 进行拆分:
经过前向传播,我们现在已保存了输入 , , , Attention 输出 , 以及 Online Softmax 在处理完全部 K/V Block 后得到的统计量 , 。其中每个 Query 对应:
我们可以利用这些保存的信息重建 与 :
从 Loss 开始反向传播,我们可以从 开始依次计算得到各个梯度的局部贡献,首先是
接下来
最后
1.2.3 整体流程
dQ = zeros_like(Q)
dK = zeros_like(K)
dV = zeros_like(V)

for j in range(Tc):

    # HBM -> SRAM
    Kj = load(K[j])
    Vj = load(V[j])

    # Accumulate gradients for current K/V block
    dKj = zeros_like(Kj)
    dVj = zeros_like(Vj)

    for i in range(Tr):

        # HBM -> SRAM
        Qi  = load(Q[i])
        Oi  = load(O[i])
        dOi = load(dO[i])
        mi  = load(m[i])
        li  = load(l[i])
        dQi = load(dQ[i])

        # 1. Recompute attention scores
        Sij = scale * (Qi @ Kj.T)

        # 2. Recompute globally normalized P block
        Pij = exp(Sij - mi[:, None]) / li[:, None]

        # 3. Gradient w.r.t. V
        dVj += Pij.T @ dOi

        # 4. Gradient w.r.t. P
        dPij = dOi @ Vj.T

        # 5. Global softmax reduction term
        Di = sum(dOi * Oi, axis=-1)

        # 6. Gradient w.r.t. S
        dSij = Pij * (dPij - Di[:, None])

        # 7. Gradient w.r.t. Q and K
        dQi += scale * (dSij @ Kj)
        dKj += scale * (dSij.T @ Qi)

        # SRAM -> HBM
        store(dQ[i], dQi)

    # SRAM -> HBM
    store(dK[j], dKj)
    store(dV[j], dVj)

return dQ, dK, dV
FlashAttention 2: Parallelism & Work Partitioning
我们可以发现,FlashAttention 1 重点解决了注意力机制在 GPU 上计算的访存瓶颈,不过显然,我们还需要关注 GPU 计算时计算资源利用率的主题——FlashAttention 2 主要关注以下三个要点:
- 让更多计算通过 Tensor Cores 高效完成
- 提高并行性,产生更多可以同时执行的 Thread Block
- 让每个 Thread Block 内部的 Warp 少做无谓的数据交换
2.1 优化 Online Softmax
自从 Volta(Tesla V100)引入 Tensor Core 起,现代 GPU 的矩阵乘法能力逐渐变得远强于一般标量计算能力——在已经经过高度优化的 Attention Kernel 中,即使非矩阵乘法操作占 FLOPs 的比例很小,也可能形成重要的性能负担。也就是说,我们希望尽可能地减少非矩阵乘法操作。
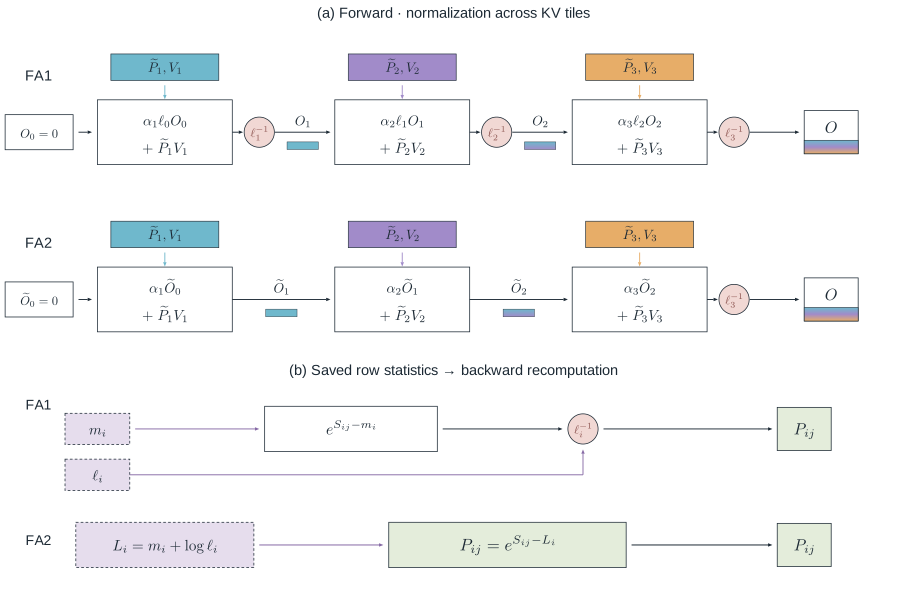
我们回顾 FlashAttention 1 对于 Attention 输出的更新过程
每处理一个新的 KV Block,都要对已有的输出和新加入的贡献进行归一化缩放——而这些非矩阵乘法操作,我们便可以展开优化。
一个简单的思路即将归一化操作置于最后一步,我们每次先更新分子(其实也就是维护 FlashAttention 1 中的 ):
其中
最后,我们只需执行一次归一化
对于反向传播中 的重计算,我们同样可以通过适当的变形来优化计算过程
其中,我们规定
也就是说,对于每一行,我们只需保存
这一个标量而不需要单独使用 和 来进行指数计算与归一化。
2.2 沿 Sequence 维度并行化
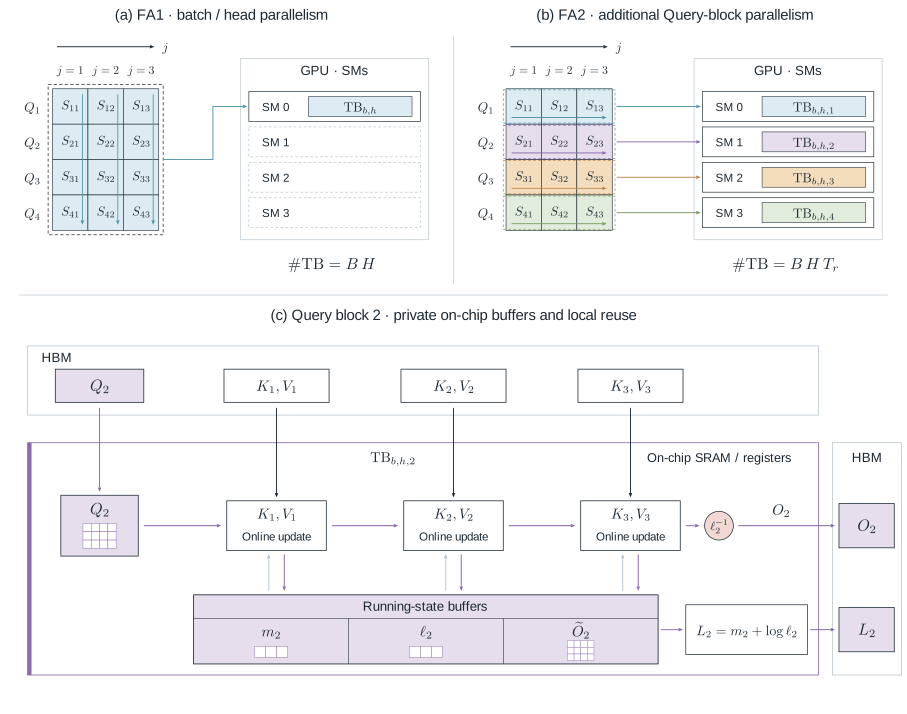
在 FlashAttention 1 中,Tile 的划分采用先遍历 KV Block、再遍历 Query Block 的方式。计算过程中,主要沿 Batch Size 和 Number of Heads 进行并行,每个 Attention Head 由一个 Thread Block 负责。这就导致了可并行任务数量不足的问题——Batch Size 和 Number of Heads 的乘积小于 GPU SM 单元的数目,也就是算法的并行性不足。
我们考虑 Attention 矩阵中的数据依赖关系,对于同一个 Query,需要依次遍历 KV Block 以递推式地做 Online Softmax 以得到最终的结果;而 Query 与 Query 之间则不存在任何的数据依赖关系,这启发我们在 Query 维度做并行。
不同 KV Block 也可以独立计算局部统计量,再通过可结合的归并操作得到全局结果。
不过这样需要额外的归并机制,可能带来通信和存储开销。
parallel_for i in range(num_query_blocks):
    Q_i = load_query_block(i)

    m = -inf
    l = 0
    acc = 0

    for j in range(num_kv_blocks):
        K_j, V_j = load_kv_block(j)

        # Online Softmax
        update(m, l, acc, Q_i, K_j, V_j)

    store_output(i, acc / l)
在 FlashAttention 2 中,我们首先在 Query 层级分配计算任务,然后对于每一个 Query 独立维护相应的 ,直到得到最终结果——这样做的好处在于中间变量始终保存在片上存储中,避免了反复的 HBM 数据交换;不过,它也可能增加不同 Query Block 对相同 KV Block 的重复读取。
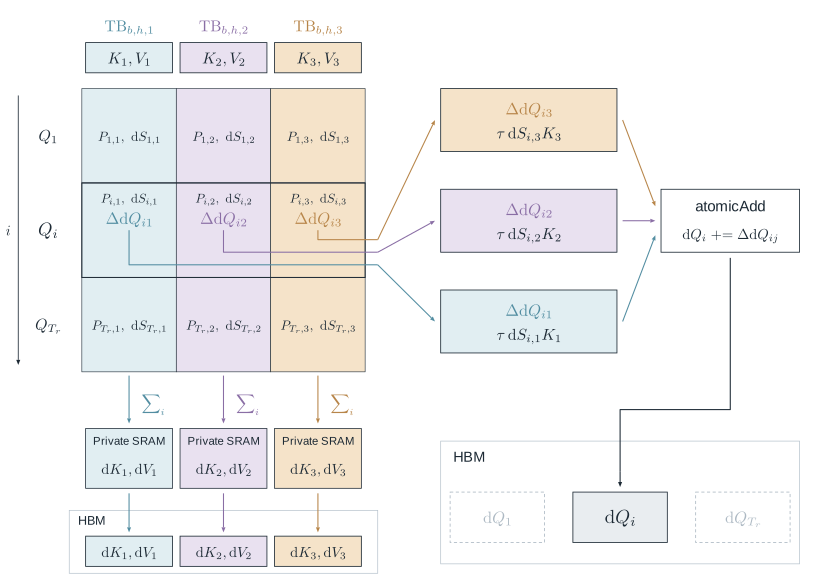
对于反向传播而言,我们先回顾 , , 的更新方式
可以发现,计算 时需要沿行累积,而计算 时则需要沿列累积——这就导致了我们需要权衡相应的并行策略。在 FlashAttention 2 中,我们按照 Key Block(即 Attention Matrix 的列块)分配反向传播的 Thread Block,我们可以简单理解为 的累加时不会产生数据冲突。
当然,对于 而言,多个 Key Block 的 Worker 都会更新同一个 ,因此需要跨 Thread Block 的累加机制,此处我们采用 Atomic Add(原子加法)。
大致的实现方式如下:
parallel_for j in range(num_kv_blocks):
    K_j, V_j = load_kv_block(j)

    dK_j = 0
    dV_j = 0

    for i in range(num_query_blocks):
        # 重算局部 Attention
        # 计算 dS_ij

        dK_j += dS_ij.T @ Q_i
        dV_j += P_ij.T @ dO_i

        atomic_add(dQ_i, dS_ij @ K_j)

    store(dK_j, dV_j)
2.3 改变 Warp 之间的任务划分
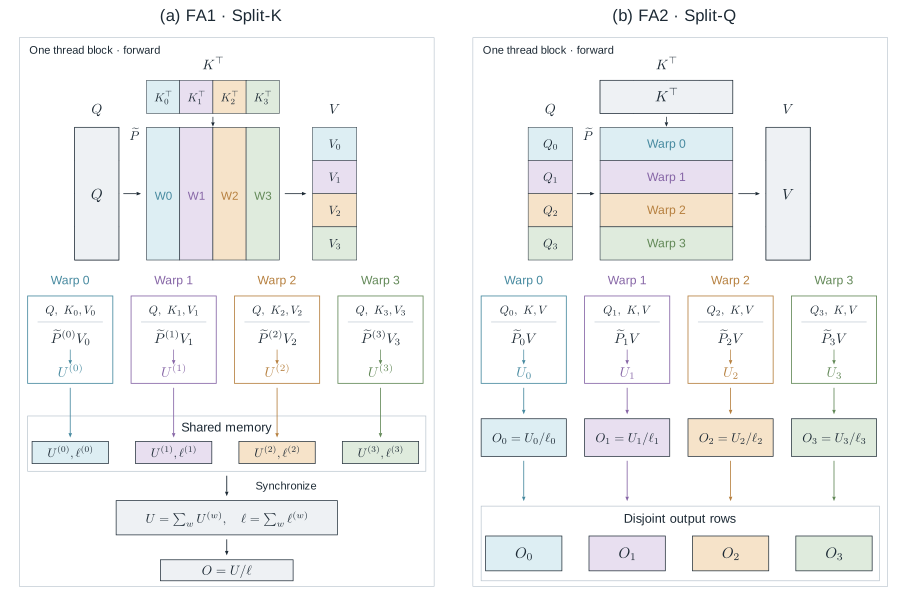
在 2.2 节中,我们主要解决的是 Thread Block 级别的并行,然而,即使 GPU 已经有足够多的 Thread Block,单个 Thread Block 的执行效率仍然可能很低。对于 FlashAttention 1 而言,不同的 Warp 负责不同的 Key / Value,在单个 Warp 的计算任务完成后,还需要进行归约以合并各个 Warp 的局部结果。在这一过程中,需要使用 Shared Memory 进行通信,也就导致了 Thread Block 内部的通信性能开销。
在 FlashAttention 2 中,我们沿用 Query 之间不存在数据依赖的关系的思路进行优化——不同 Warp 分别处理不同的 。由于不同 Warp 负责的 Query 行互不重叠,因此它们不需要进行输出的跨 Warp 求和,减少了由于任务划分不合理而产生的跨 Warp 通信和归并。
FlashAttention 3: Asynchronous Execution & Pipelining
随着 GPU 硬件的进一步发展,GPU 对于矩阵乘法的运算能力进一步提升,但是 FlashAttention 2 并没有充分利用这种能力——例如,在 NVIDIA H100 上,FA2 只能达到大约 35% 的理论峰值 FLOPs 利用率,而优化良好的 GEMM Kernel 可以达到约 80%–85%。
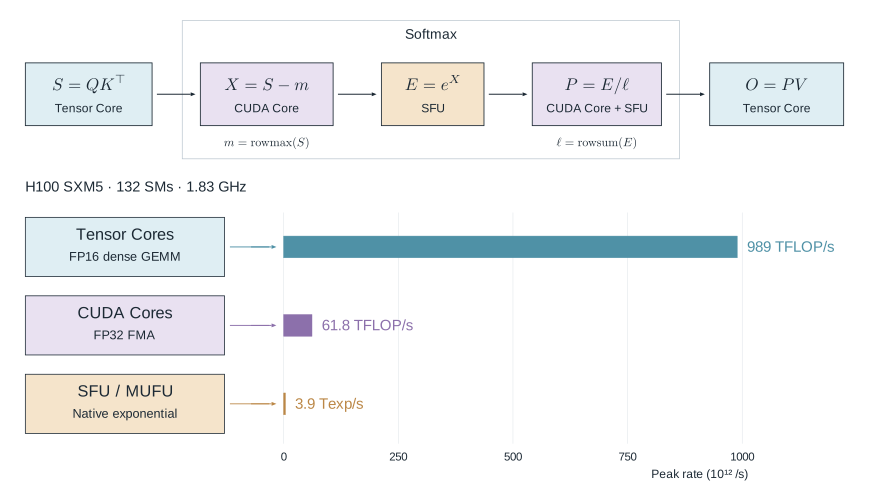
本质的原因在于 Attention 的计算过程中包含各类运算,而 GPU 对于处理这些运算的硬件单元的吞吐能力非常不均衡。我们将 Attention 的主要计算分为三个部分:
对于 GEMM (通用矩阵乘法)运算,通常利用 Tensor Core 执行;而对于非 GEMM 运算,则利用 CUDA Core、SFU / MUFU 等硬件单元执行,由于 Tensor Core 的峰值吞吐量远大于 SFU,因此即使 Softmax 等非 GEMM 运算的数量远小于 GEMM 运算,也能造成较大的计算成本开销。
更进一步的,Tensor Cores 和执行 Softmax 的硬件不是同一组执行单元,也就是说我们不必将矩阵运算与 Softmax 运算完全串行执行,在 FlashAttention 3 中,我们利用不同 Block 之间的计算,将原本串行的数据依赖重组为可以流水线执行的形式。
3.1 Hopper GPU 的新特性
Hopper(H100)在 GPU 执行模型上带来了新的变化,其中最核心的一点是,Hopper 让数据搬运、矩阵计算和其他 CUDA 指令能够以更明确、更细粒度的异步方式协同执行。
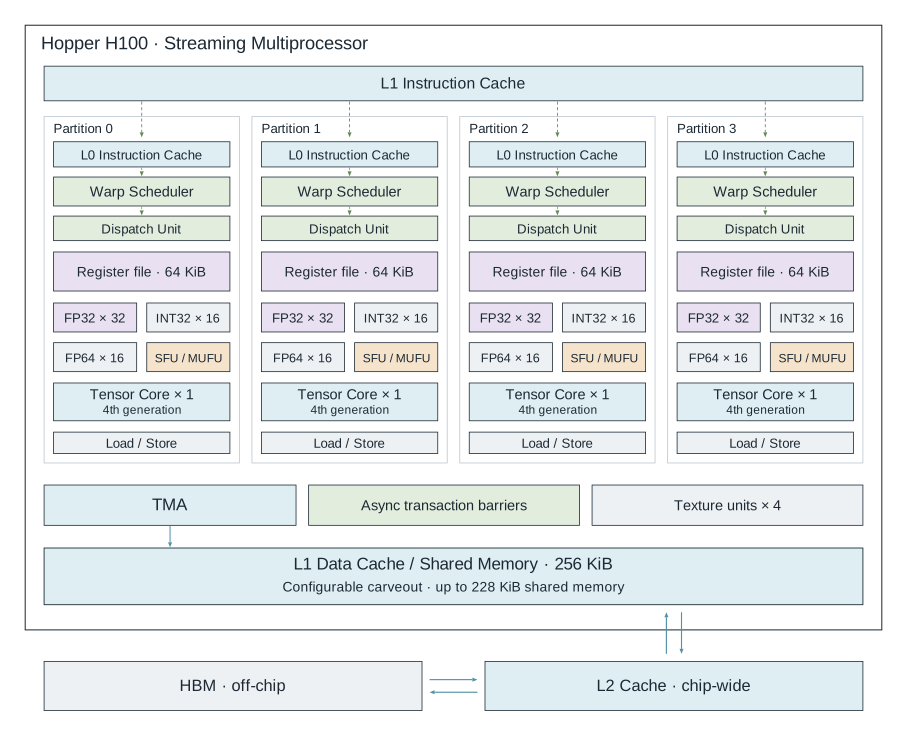
在一个 SM 单元中,Warp Scheduler 负责调度指令,让相应的硬件执行单元工作。对于一个 CUDA Thread 而言,它不直接调度相关的硬件单元,它执行的指令由 GPU 的调度与分派机制送往相应的执行资源。
3.1.1 WGMMA: Warpgroup Matrix Multiply-Accumulate
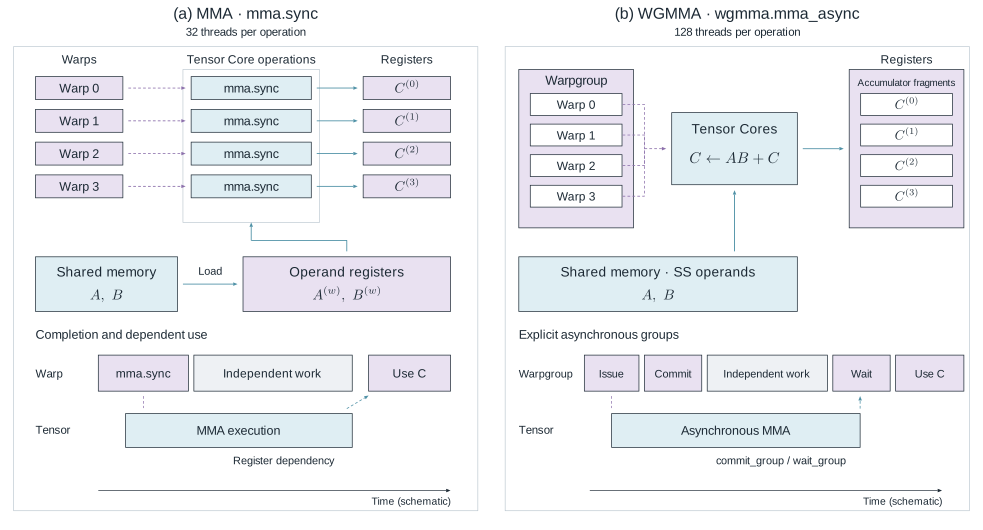
Hopper WGMMA 由传统 Warp-level MMA 演化而来,主要用于矩阵运算的过程。WGMMA 的核心改进可以归纳为以下三点:
- 更大规模的线程协作:从 Warp(32 Threads)扩展到 Warpgroup(128 Threads)以支持更大粒度的矩阵计算与协作
- 直接访问 Shared Memory:支持从 Shared Memory 直接读取矩阵操作数以减少显式 SMEM → Register 数据搬运和寄存器压力
- 异步执行:发起 WGMMA 后,无须立即等待计算完成,这为矩阵计算与其他独立操作的重叠提供机会
3.1.2 TMA: Tensor Memory Accelerator
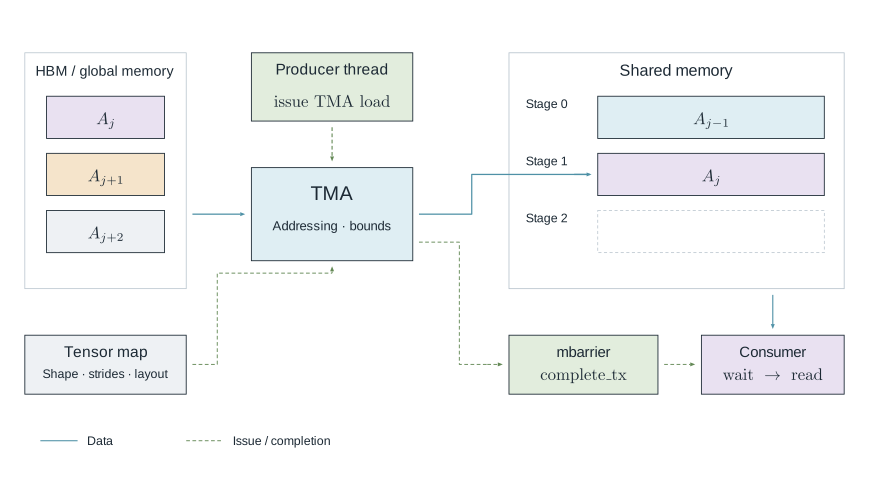
TMA 解决的主要问题是怎样更高效地把矩阵数据送到 Tensor Cores 可以使用的位置。在传统 CUDA Kernel 中,一般可以让不同线程负责读取 Tile 中的不同元素。在数据的读取过程中可以分为两类主要工作:
- 真正的数据传输:
- 地址计算与控制:
而这些工作会消耗指令发射资源,也可能占用大量寄存器。更进一步的,为了完成一个矩阵运算,大量的指令执行反而发生在数据搬运阶段而非计算阶段。
在 Hopper 之前的 Ampere 架构中,我们可以通过 cp.async 的指令把数据从 Global Memory 异步复制到 Shared Memory,避免传统的显式 Global Load 到寄存器、再由寄存器 Store 到 Shared Memory 的过程。然而,这仍然需要线程负责比较多的工作。在 Hopper 架构中,TMA 将数据搬运的工作进一步交给专用硬件。
在使用 TMA 时,Kernel 可以通过 Tensor Map 和相应的坐标发起搬运请求,之后 TMA 根据 Tensor Map 完成地址生成与数据传输。注意,真正的数据传输是由 TMA 异步执行的——我们可以使用 Shared Memory 中的 mbarrier 实现更细粒度的同步,即我们可以跟踪 TMA 异步数据传输的完成情况,使得后续对于相应 Shared Memory 的访问得到安全执行。
3.1.3 Warp Specialization
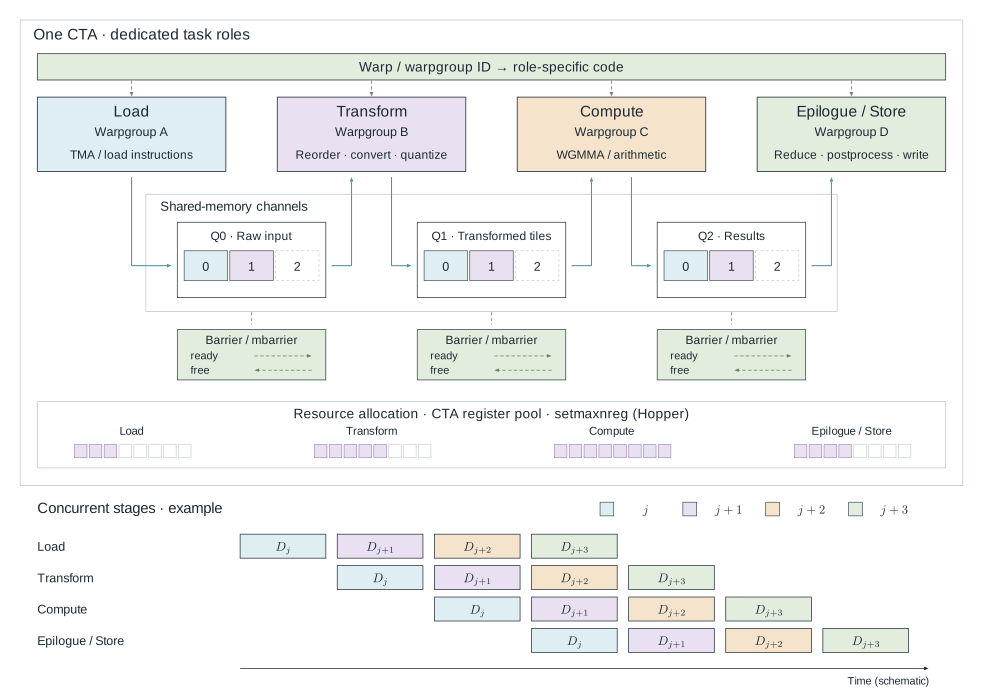
Warp Specialization(Warp 专门化)是一种 Kernel 组织技术,实际上并不是 Hopper 首次发明的硬件功能。但 FlashAttention 3 中使用到的资源分配机制 setmaxnreg 则是 Hopper 架构起才有的。
我们可以简单将 WGMMA 与 TMA 分别理解为对矩阵乘法和数据搬运的异步执行操作,而 Warp Specialization 则通过将工作划分为不同角色,进而把 WGMMA 和 TMA 真正组织起来。
在传统的执行方式中,通常让所有 Warp 依次参与多阶段的计算任务,只不过处理的数据不同。然而,如果我们希望实现流水线,就需要让数据加载与计算交叠起来。Warp Specialization 便提供了实现流水线的思路——Warp Specialization 的本质是在同一个 CTA 内,将不同 Warp(或 Warpgroup)专门分配给不同任务,并通过共享内存、同步机制和资源分配机制,让它们形成高效的异步流水线。
在实际实现过程中,我们直接根据 Warp ID 执行不同的代码,以将 Warp 划分为不同的任务角色。我们可以将 Warp 间的协作划分为为四个层次,以建立 Warp 之间的数据流动关系:
- 数据协作:不同 Warp 之间通过 Shared Memory 来共享数据
- 执行同步:通过 Barrier 和 mbarrier,我们可以建立起不同 Warp 之间的执行同步关系
- 异步协作:为建立起一套高效的异步流水线,我们可以利用 TMA、WGMMA 等异步完成机制
- 资源协作:不同 Warp 对于资源的利用需求不同,我们可以使用 setmaxnreg 来重新分配寄存器预算
3.1.4 FP8 Tensor Cores
Hopper 的 FP8 使用 8 Bit 表示一个浮点数,相较于 FP16,可以提供约两倍的理论矩阵乘法吞吐量,有利于进一步加速 Attention 的运算。
3.2 异步流水线
3.2.1 Producer-Consumer 异步流水线
在 FlashAttention 2 中,我们按照 Query Blocks 划分 CTA,不同 CTA 计算不同的 Query Blocks,而一个 CTA 内部遍历所有相关的 KV Blocks。在此基础上面,我们只分析一个 CTA,并在此基础上推导建立异步流水线的机制。
我们首先可以将数据搬运与矩阵运算分离,利用 Warp Specialization 将两类工作交给不同的 Warpgroup。
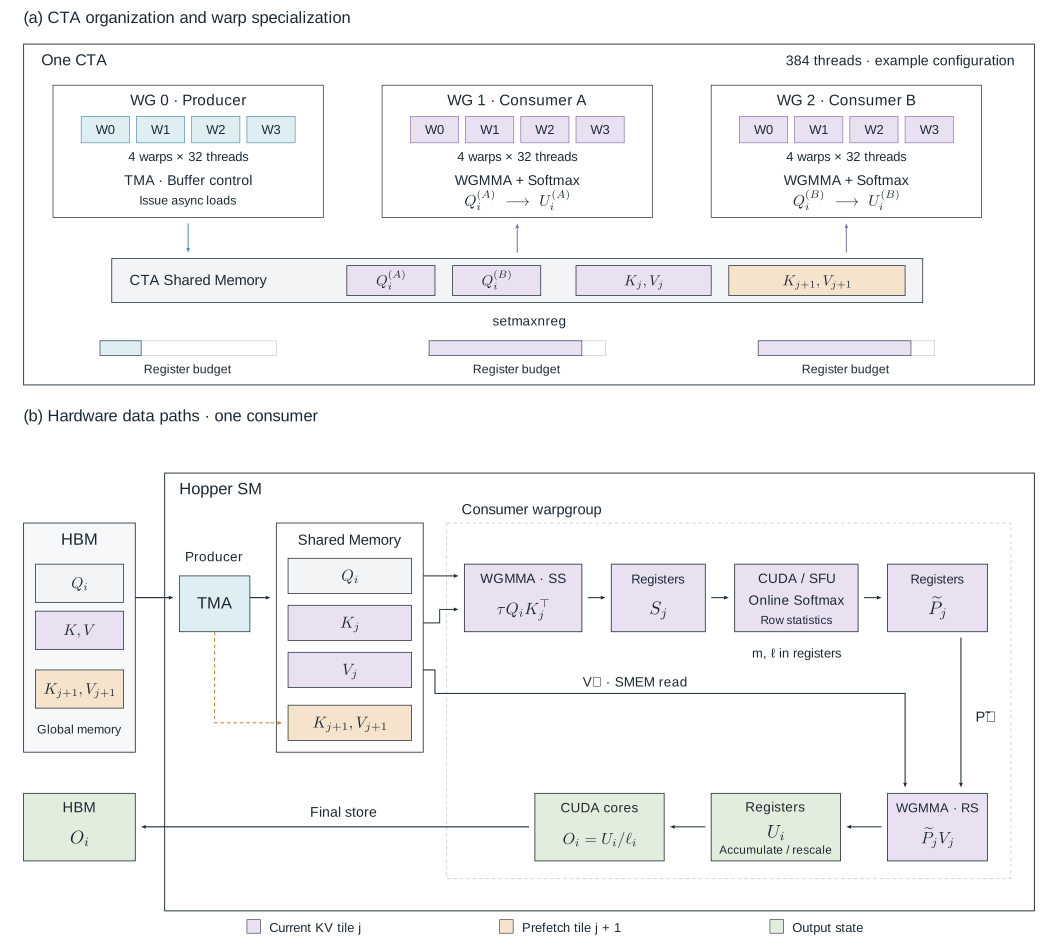
具体而言,一个 CTA 可以包含三个 Warpgroup
- Producer 负责发起 TMA,将数据从 HBM 加载到 Shared Memory——实现时 Producer 只调用 Warpgroup 中的一个 Warp 发起 TMA,而 Warpgroup 的作用在于保证与 Consumer 的对应关系,使得能利用 setmaxnreg 进行寄存器再分配。
- Consumer 专门执行 KV Block 的计算过程——Consumer A/B 处理不同 Query 行,复用相同的 K/V 数据。
我们使用 Circular Shared Memory Buffer 来实现数据加载与计算的异步流水线。
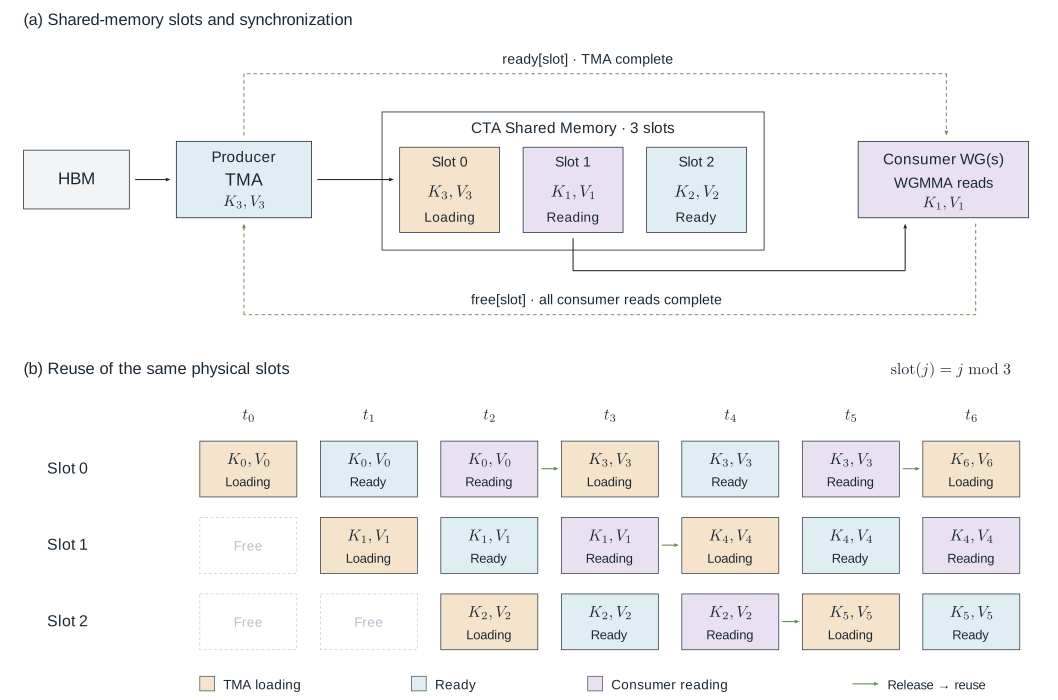
具体而言,我们将 Shared Memory 划分为若干个独立的 Slots。对于 Producer,它依次填满空闲的 Slot,供 Consumer 使用;而对于 Consumer,在 TMA 将数据加载完成后,进行相应的计算,并在保证安全完成对旧数据的使用后允许 Producer 覆盖该 Buffer。每个 Buffer 都要经历 的生命周期。
整体流程可以理解为
- Producer
TMA load Q_i once

for j = 0, 1, 2, ...:
    wait until buffer[j % s] is reusable

    issue TMA load K_j, V_j

notify consumers when data is ready- Consumer
wait until Q_i is ready

for j = 0, 1, 2, ...:
    wait until K_j is ready

    GEMM0: S_j = Q_i K_jᵀ

    OnlineSoftmax(S_j)

    wait until V_j is ready

    GEMM1: U += P̃_j V_j

    release buffers when safe
3.2.2 两阶段 WGMMA–Softmax Pipeline
当前,我们已经实现了数据搬运与计算的异步流水线,然而,对于 Consumer 内部的 GEMM 和 Softmax ,仍然存在明显的串行执行阶段。由于 GEMM 与 Softmax 的运算分别由不同的硬件执行单元执行,我们期望 GEMM 与 Softmax 运算能够实现并行。
我们首先考虑块与块之间的数据依赖关系与硬件单元的利用情况,我们将一个 KV Block 的计算拆分为三个阶段,对于第 个 KV Block:
- 执行第一次 GEMM: (Tensor Cores)
- 执行 Online Softmax: (CUDA Cores / SFU)
- 执行第二次 GEMM: (Tensor Cores)
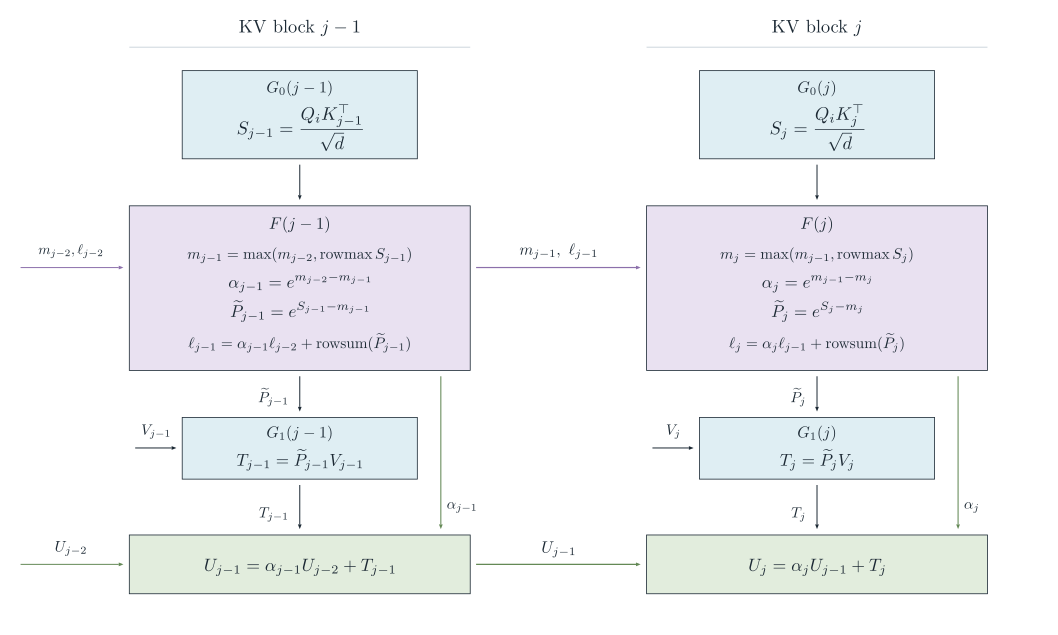
进一步考虑第二步 的更新过程:
在该更新过程中, 的结果并不依赖于上一块的结果 。
我们可以通过观察数据依赖关系重排执行顺序以达到并行的目的——我们可以发现 只依赖于 与 ,而不依赖与 ,因此我们可以考虑调整 与 的执行顺序,我们可以先执行 ,再考虑让 与 并行。
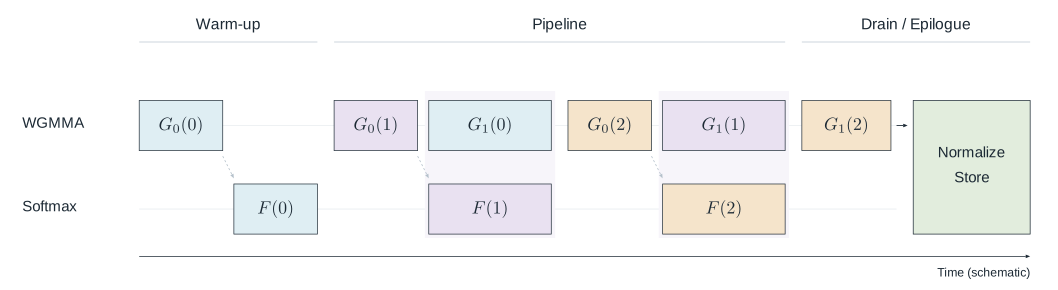
具体而言,我们首先需要为相邻的两个 Block 同时准备寄存器缓冲区以保存 的中间产物。之后,我们首先经过预热步骤完成 与 的计算,接着就按流水线进行并发的运算,并不断更新输出累加器。在处理到最后一个 KV Block 时,我们将最后一个 运算执行完毕,并相应做归一化和相关结果的保存。
3.2.3 PingPang Scheduling
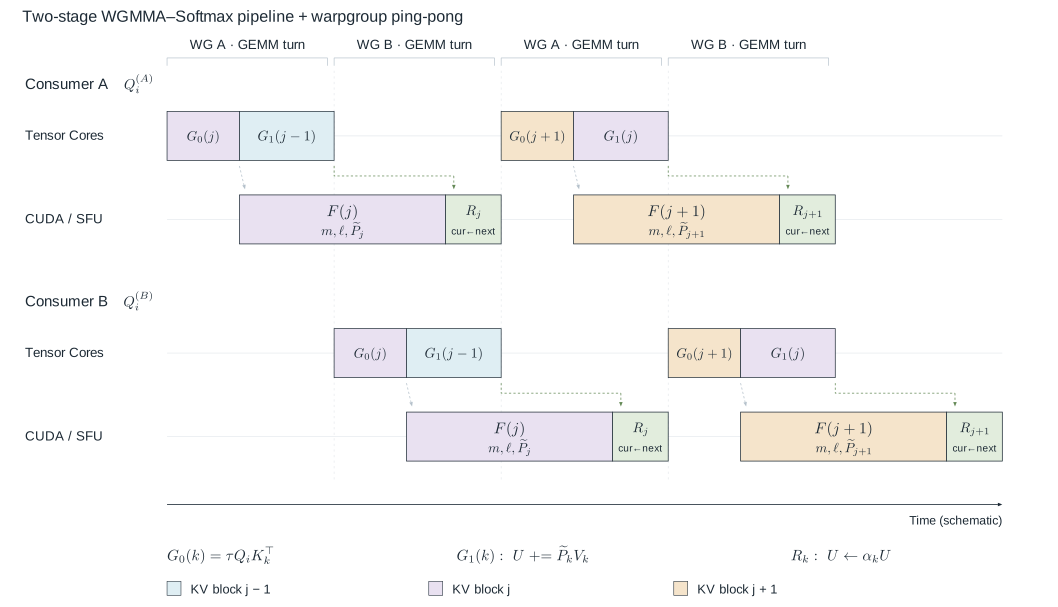
除了单纯的 Consumer 内部的流水线并行,我们还可以考虑两个 Consumer 之间的指令执行安排——我们可以考虑类似于插空的策略,当 Consumer A 进行非 GEMM 运算时让 Consumer B 启动 GEMM 运算,利用两组 Warpgroup 之间的独立工作隐藏 Softmax 延迟。
整体流程
void consumer(int wg) {
    int other = 1 - wg;

    // 初始化:处理第 0 个 KV Block
    S_cur = GEMM0(0);              // Q @ K[0].T
    wait_gemm0();
    P_cur = softmax_online(S_cur);

    for (int j = 1; j < num_blocks; ++j) {

        // ===== Ping-Pong =====
        wait_turn(wg);

        // ===== Two-Stage Pipeline =====
        S_next = GEMM0_async(j);       // Q @ K[j].T
        GEMM1_async(P_cur, V[j-1]);    // P[j-1] @ V[j-1]

        // ===== Ping-Pong =====
        signal_turn(other);

        // ===== Two-Stage Pipeline =====
        wait_gemm0();
        P_next = softmax_online(S_next);

        // GEMM1(j-1) 可能与 Softmax(j) 重叠
        wait_gemm1();
        rescale_output();

        P_cur = P_next;
    }

    // 完成最后一个 KV Block
    GEMM1(P_cur, V[num_blocks-1]);
    finalize_output();
}
3.3 FP8 优化
在 GPU 中,FP8 矩阵乘法的理论峰值吞吐量远大于 FP16,这也就启发我们降低计算精度,从而提升 Tensor Core 的理论吞吐能力。然而,如果只是单纯把 等从 FP16 转成 FP8,则会引入比较明显的量化误差。也就是说,我们需要设计一些量化策略,达到精度与吞吐量的平衡。
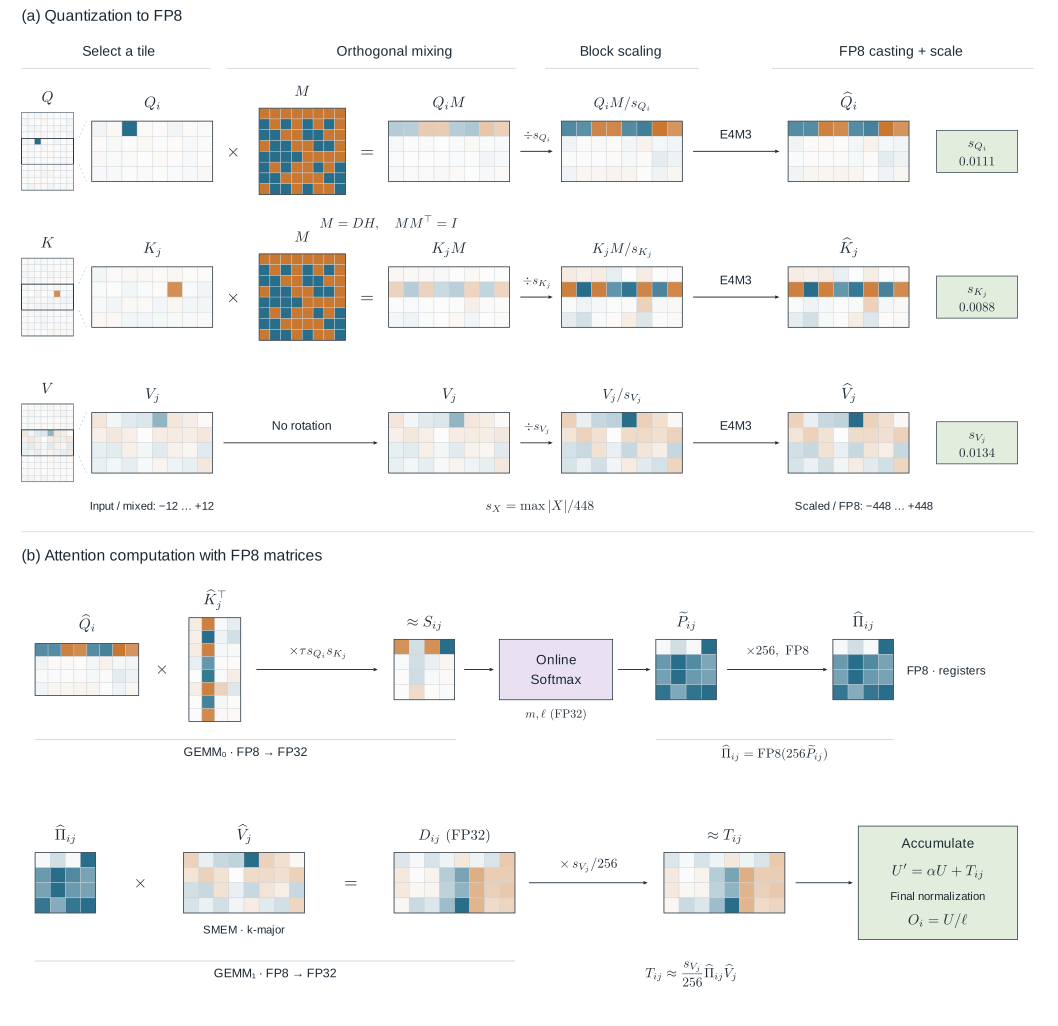
简单来说,我们可以将 FP8 量化分为三个不同阶段:
3.3.1 Block Quantization
矩阵的数值分布很可能是不均匀的,如果矩阵中存在少量离群值,并且整个矩阵共享一个 Quantization Scale 的话,则会导致Scale 必须兼顾那个非常大的数值,进而降低其他小数值能够使用的有效量化精度。因此,我们采取对矩阵分块的策略,对于每个 Tile,分别计算自己的量化比例(并且这与 FlashAttention 本身的 Tiling 策略可以结合起来),即使每个 Tile 内部存在较大的异常值,也不会显著影响整体的结果。
3.3.2 Incoherent Processing
在保证 , 乘积不变的前提下,我们考虑对同一个 Attention Head 中的所有 (Q) 和 (K) 使用同一个随机正交矩阵 ,通过变换使得矩阵的数值分布尽量平滑,以减小较大异常值对于结果的影响。
具体而言,我们使用 Hadamard 矩阵,构造变换
由于 是正交矩阵,因此
理论上的 Attention Score 不会因此发生改变。
特别的,我们使用 Hadamard 变换,利用 Fast Walsh-Hadamard Transform(FWHT),可以将计算复杂度降低至
3.3.3 Scaling
我们要将一个 FP16 张量 转换为 FP8,由于 FP8 E4M3 能表示的最大有限正数是 448,因此我们需要使用一个缩放因子来充分利用 FP8 的数值范围
在后续的矩阵乘法中,利用该缩放因子则能复原正确结果。
除此之外,为满足 Hopper 的 WGMMA 对 FP8 Operand 有特定的寄存器数据布局要求,FlashAttention 3 中还利用了寄存器内数据重排与 Warp Shuffle 等机制,此处讲解过程省略。
3.4 反向传播
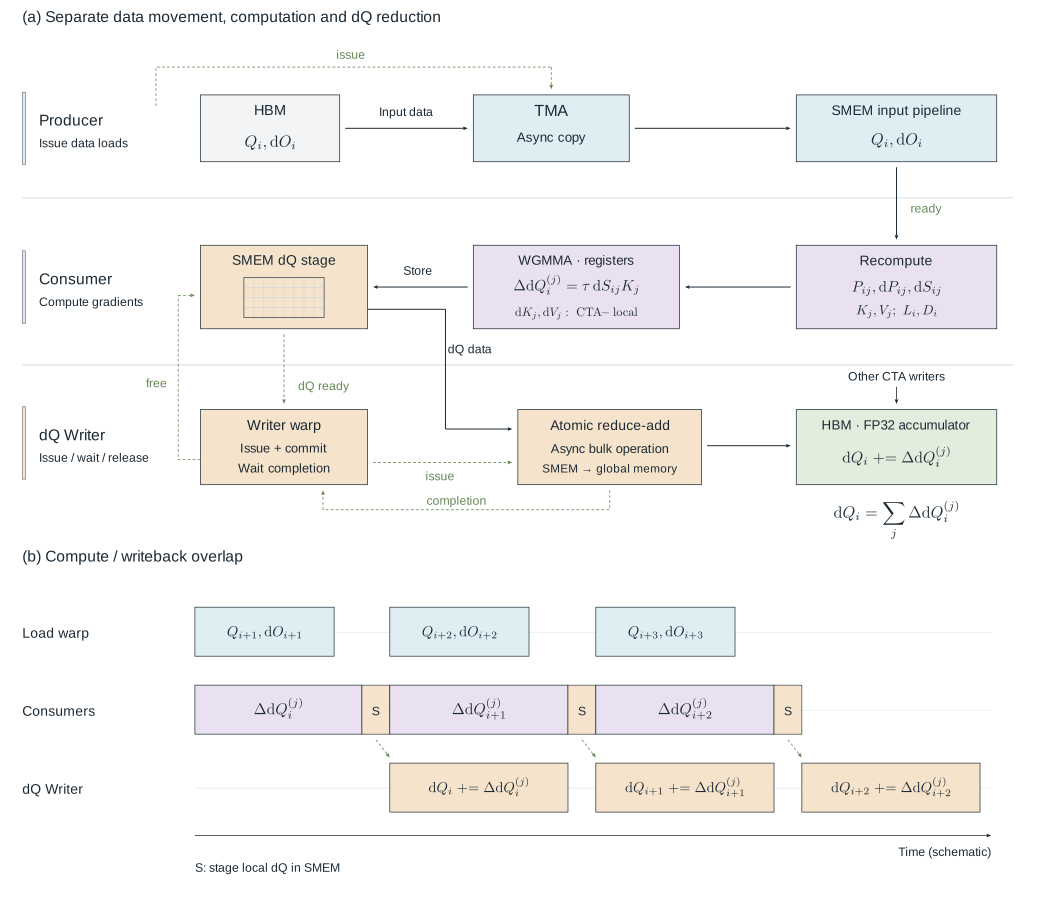
反向传播过程中依然沿用数据搬运与计算分离的思想,不过更进一步的,反向传播将 的更新也优化为异步执行——这避免了在计算过程中,因 原子更新时的失败而导致的计算阻塞问题。
整体过程如下
// CTA j owns K_j, V_j, dK_j and dV_j

parallel {

    Producer:
        async_load(K_j, V_j);

        for (i : query_blocks) {
            wait_input_buffer_free();
            async_load(Q_i, dO_i);
            signal_input_ready();
        }


    Consumer:
        dK_j = 0;
        dV_j = 0;

        for (i : query_blocks) {
            wait_input_ready();

            S  = scale * Q_i @ K_j.T;
            dP = dO_i @ V_j.T;

            P  = exp(S - L_i);
            dS = P * (dP - D_i);

            dV_j += P.T @ dO_i;
            dK_j += scale * dS.T @ Q_i;

            local_dQ = scale * dS @ K_j;

            wait_dQ_buffer_empty();
            smem_dQ = local_dQ;
            signal_dQ_buffer_full();
        }

        store(dK_j, dV_j);


    dQ_Writer:
        for (i : query_blocks) {
            wait_dQ_buffer_full();

            async_reduce_add(
                global_dQaccum[i],
                smem_dQ
            );

            wait_until_buffer_safe_to_reuse();
            signal_dQ_buffer_empty();
        }
}