GRU 的核心思路:让 RNN 自学习过去的信息应当保留多少、当前的新信息应该写入多少,以及在生成新信息时应该参考多少过去
1 普通 RNN 的核心问题
将 RNN 记作
ht=tanh(Wxxt+Whht−1+b)
RNN 每到来一个新 token,都要做一次非线性变换,那么对于长序列的反向传播:
∂h1∂hM=t=2∏M∂ht−1∂ht
其中 M 为一个较大数,则会导致梯度消失、梯度爆炸、长期记忆困难的问题。
2 GRU 的整体结构
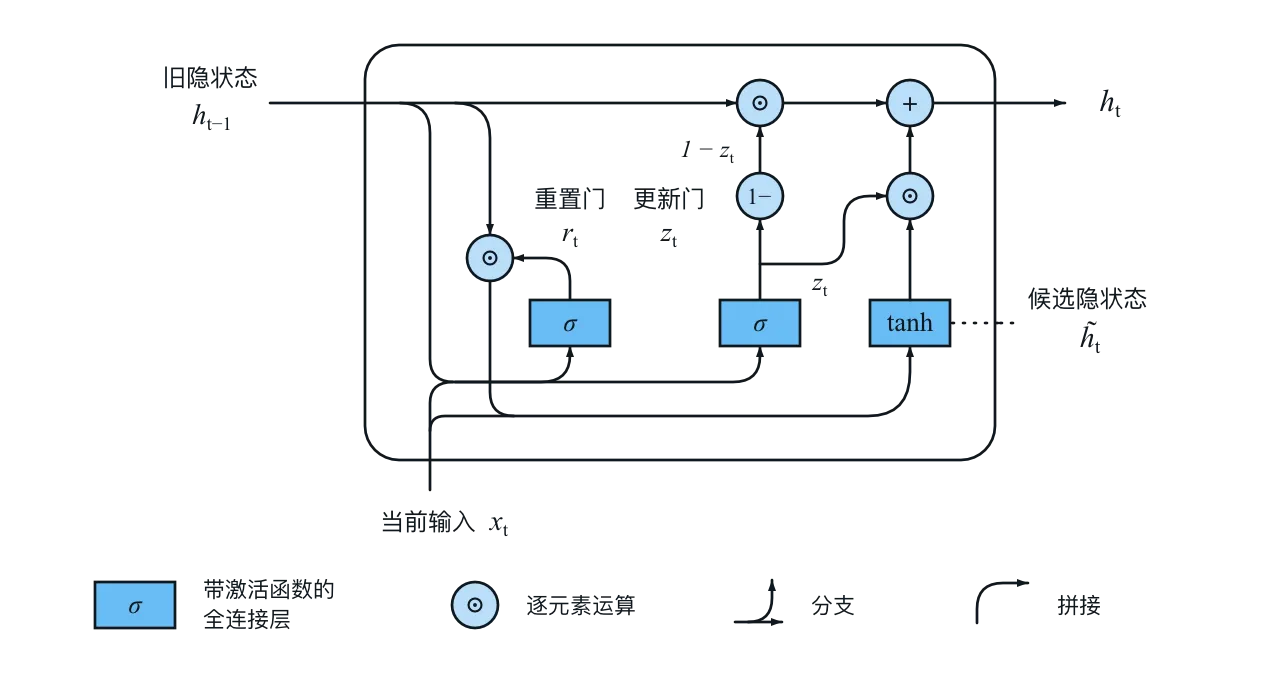
- 更新门:zt=σ(Wzxt+Uzht−1+bz)
- 重置门:rt=σ(Wrxt+Urht−1+br)
- 候选隐藏状态:h~t=tanh(Whxt+Uh(rt⊙ht−1)+bh)
最终隐状态的更新可表示为:
ht=(1−zt)⊙ht−1+zt⊙h~t
3 门控机制
“门”被定义为类似于下式的形式:
zt=σ(⋯)
sigmoid 函数的值域为 (0,1) ,我们可将门控理解为一个可微分的、连续的、逐维的信息流控制器。
对于重置门 rt ,其主要决定计算候选新状态时,要使用多少旧信息,即生成新状态时如何参考过去的记忆:
h~t=f(xt,rt⊙ht−1)
对于更新门 zt ,其主要决定新生成记忆的修改,即如何控制原有记忆与候选新状态的比例:
ht=(1−zt)ht−1+zth~t
更进一步的,更新门本质上可以理解为残差更新:
ht=ht−1+zt⊙(h~t−ht−1)
那么此种方式使得 GRU 得以保存长期的记忆,并且缓解了梯度消失、梯度爆炸的问题。
4 GRU 如何解决传统 RNN 的问题
4.1 长期记忆的保留
对于传统 RNN:
ht=tanh(Wxxt+Whht−1+b)
每次更新时,ht 都要重新计算一次状态,旧状态的保留比较困难,不利于长期记忆的建立。那么使用 GRU 更新门的机制,可以让模型学会完整保留旧的记忆状态。
从另一个角度,定义 Δht=h~t−ht−1 ,则:
ht=ht−1+ztΔht
可以理解为 GRU 的每一步都在自己决定更新的程度与速度。
4.2 候选状态的生成自适应参考旧状态
在传统 RNN 中,每一个新状态的生成被迫依赖于旧状态,如果过去的信息对新的语义结构的影响不明显,我们可以通过一个机制来提前决定哪些旧信息应该参与新状态的生成,也就是更新门机制。
如果没有重置门,则
h~t=tanh(Wxt+Uht−1)
核心问题在于历史信息都是通过同一个 U 来处理的。而加入重置门之后:
h~t=tanh(Wxt+U(rt⊙ht−1)),
对于每一个时间步,都有动态调整的 rt ,也就是神经网络拥有了上下文相关的处理规则。当然,实际上基础的 RNN 也能够在一定程度上学习到相应的上下文关系,但是重置门的机制将相应先验直接编码至相应神经网络,使得神经网络拥有更强的对于上下文信息的处理能力。